서버를 직접 호출해 쟀다
이 물건의 주장은 명확하다. "에이전트는 이미 한 일을 다시 사는 데 컨텍스트 대부분을 태운다, 그걸 구조적으로 막는다." 광고 문구 검증에 화면은 필요 없다. npm 패키지를 격리 폴더에 설치하고 MCP 서버를 stdio로 직접 호출했다.
- 도구 19종 응답:
smart_read/write/edit/grep/glob(기본 도구 대체),wiki_write/read/query(지식그래프),token_audit·waste_audit(회계),expand(발췌 복원) - 216,000바이트 파일
smart_read첫 호출: 4,143자 반환, "관련 섹션만 유지" 발췌 + 메타데이터. 원문의 2%다 - 같은 파일 무변경 재호출: 4,143자 그대로. README의 "재읽기는 diff만"은 이 경우엔 해당 없다
- 한 줄 수정 후 재호출: 889자, 바뀐 줄의 diff만 돌아왔다. 핵심 주장이 여기서 성립한다
정리하면 절약의 두 축 모두 실측된다. 첫 읽기부터 발췌(98% 축소), 변경 후 재읽기는 diff. 대신 발췌는 손실 압축이다. 모델이 잘린 부분을 원하면 expand로 다시 사 와야 하고, 그 비용도 이 도구는 장부에 적는다.
지식그래프, 세션이 죽어도 결론은 남는다
두 번째 축은 저장이다. 세션이 알아낸 것(이 함수는 로컬 시계를 쓴다, 이 수정은 한 번 되돌려졌다 같은 결론)을 프로젝트별 그래프에 쌓고, 다음 세션이 그 파일을 건드리는 순간 되돌려준다. 결론 하나를 들고 다니는 비용 ~150토큰, 다시 알아내는 비용 5천~5만 토큰이라는 게 저자의 계산이다.
RAG와 다른 점을 저자 스스로 표로 박아 놨다. 증거가 아니라 판정을 저장하고, 배치 인덱싱 없이 실제 에이전트 트래픽에서 쌓이며, 유사도 검색이 아니라 그래프 순회이고, 소스 트리에 존재하지 않는 "막다른 길"까지 돌려준다. 이 부분은 우리가 실측하지 않았다, 설계 서술로만 옮긴다.
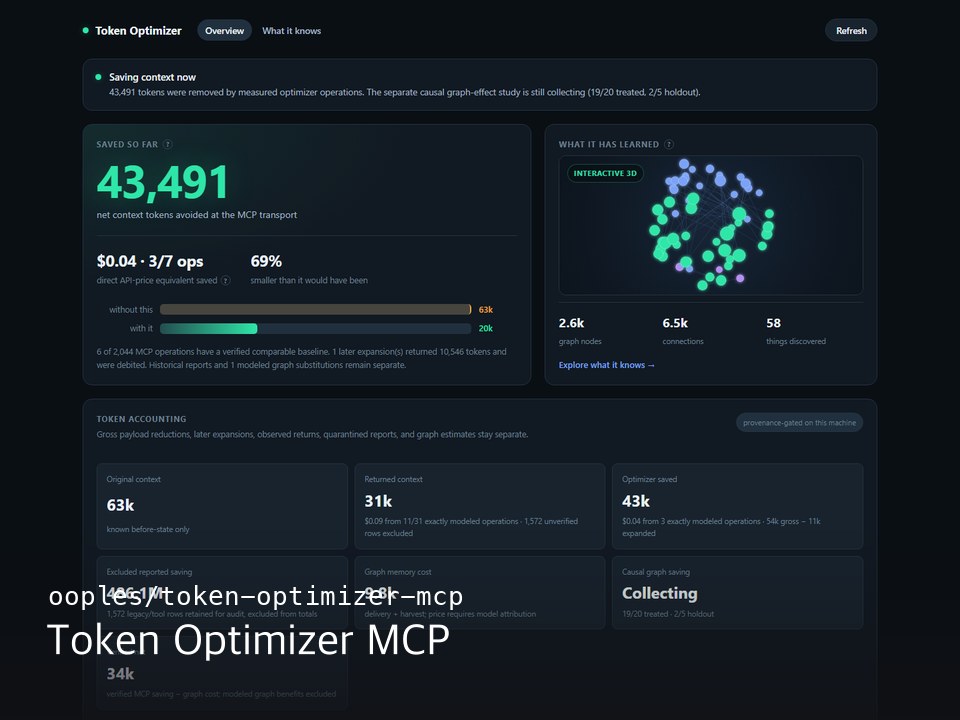
계측 문화는 이 바닥 상위권이다
README가 특이하다. 절약을 부풀리는 대신 자기 수치를 격리한다. 4.8억 토큰짜리 과거 기록은 "모델 컨텍스트에 들어간 적 없는 스캔 볼륨"이라며 검증 수치에서 빼놨고, 측정 안 된 클라이언트는 0을 지어내지 않고 "Not measured"로 두며, 그래프 효과엔 무작위 대조군을 돌린다. 물론 전부 저자 자신의 하네스에서 나온 자체 계측이다. 우리는 수치를 믿는 대신 메커니즘만 직접 쟀고, 그건 성립했다.
실체도 가볍지 않다. 커밋 562 · 최근 90일 187 · 태그 70 · 테스트 파일 293 · 70만 줄(16개 클라이언트 통합 코드 625파일이 큰 몫). 다만 실질 저자는 1명이다. 분석 기준 커밋 1d0abf1.
가져올 것과 주의
- 긴 세션에서 같은 파일을 반복해 읽는 작업(대형 리팩터·감사)이 많다면 지켜볼 가치가 있다. 재읽기 diff는 실측으로 성립한 진짜 절약이다
- "토큰 절약을 주장하려면 장부부터"라는 태도 자체가 배울 거리다. 절약치와 비용(그래프 유지비·expand 재구매)을 같은 장부에 적는 도구는 드물다
- 주의: 플러그인은 강제형이다. 기본 Read·Grep·cat을 거부하고 자기 도구로 바꾼다, 에이전트 행동 전체가 이 도구의 품질에 묶인다. 첫 읽기부터 손실 발췌라 정밀 작업에선 놓침 위험이 있고, 시맨틱 수확은 옵트인이 아니라 키가 없을 때만 꺼진다. 1인 프로젝트라는 점까지 계산에 넣고 도입하자